OPEN EXPERIMENT · v1.0.0 · Apache-2.0
从字符计数开始,
公开一次真实的 RL 训练。
Naive 在 Claude Code 中辅助完成 Qwen3-1.7B 的直接 GRPO 训练。这里留下代码、实际数据、训练日志,以及判断被结果修正的过程。
2026-11-01 实验 · 2026-11-04 开源发布 · 无 SFT · 单卡 RTX 4090 48GB
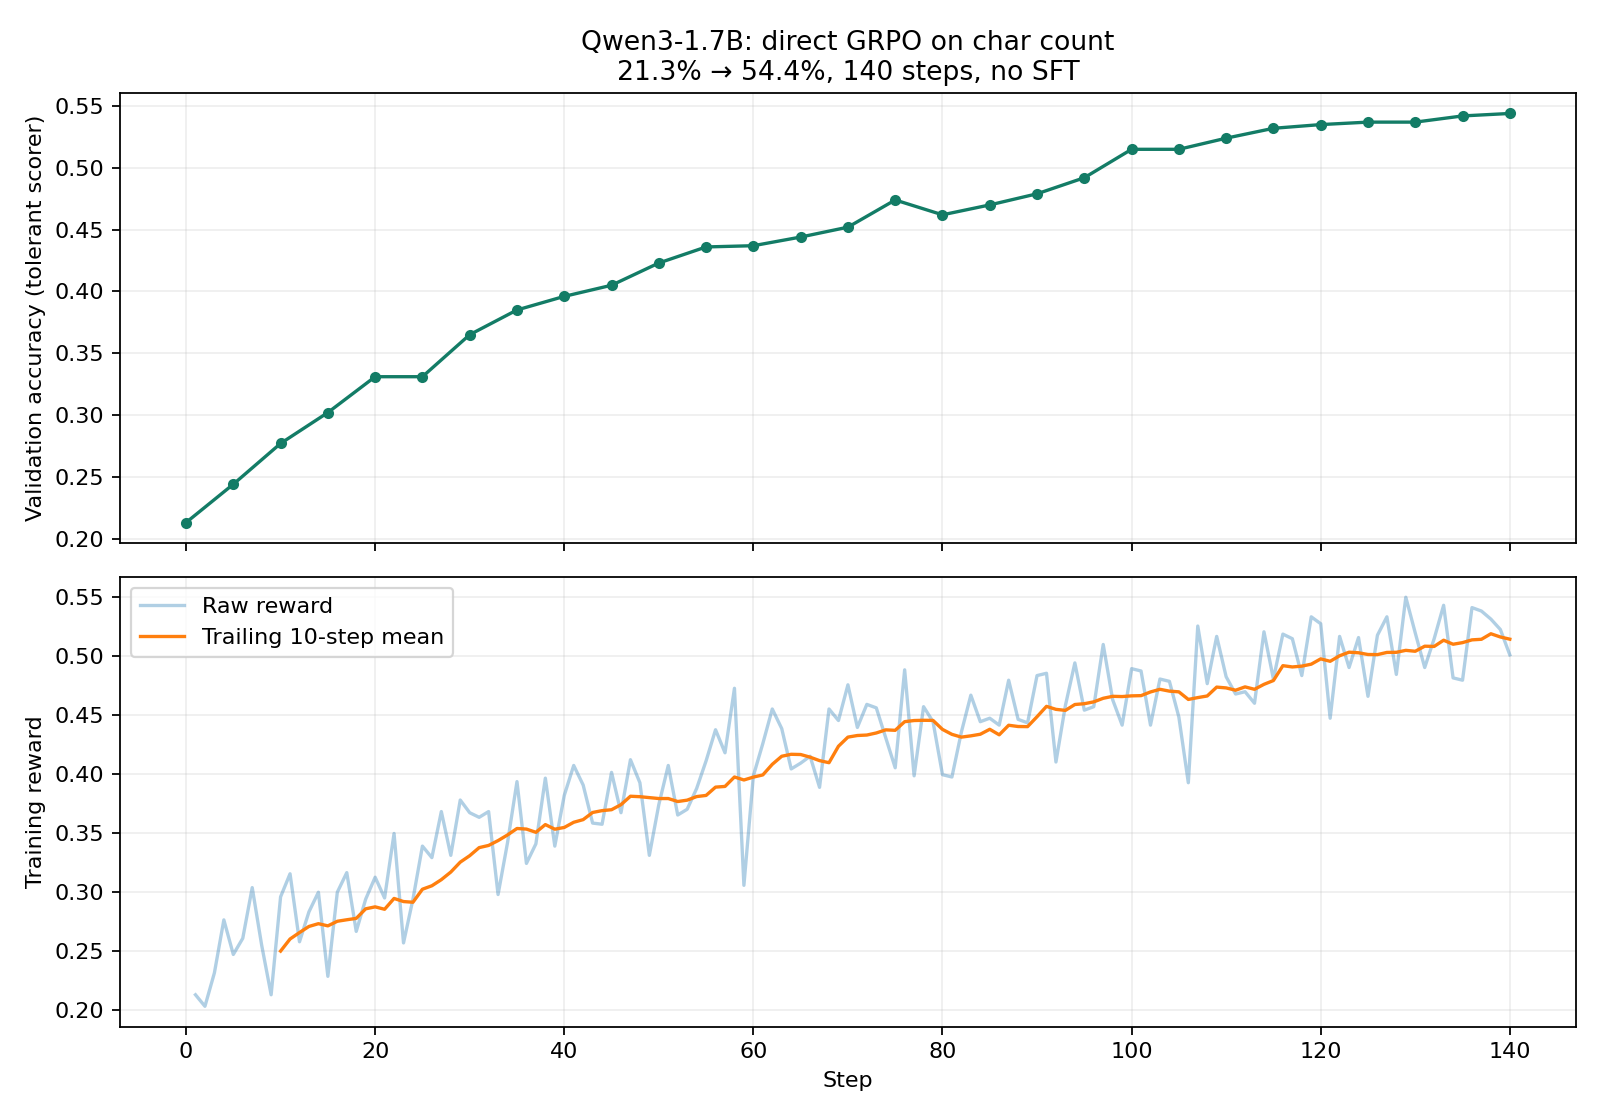
21.3 → 54.4%历史容错判分验证准确率
140 步2 epochs / 29 次验证
1h 49m 50s训练进度条记录用时
这次训练做了什么
任务很小:给出一个由连字符分隔的字符串,计算指定字母出现的次数。模型从 Qwen3-1.7B 开始,关闭 thinking,跳过 SFT,直接用可验证奖励训练。
How many a are there in word a-b-a?
→ 2
Naive 是研发助手,Claude Code 是运行工具,Qwen3-1.7B 是被训练的模型。用户选择任务、建议换模并决定训练轮数;最终轮次启动后,没有新增人工训练指令或中途修改训练参数。
过程,也包括判断的修正
- 先用 135M 试跑。 验证基线约 2.6%,提升有限,随后由用户建议换成 Qwen3-1.7B。
- 修复基线误报。 旧 watcher 把训练前 21.3% 当成训练爬坡;修正为同时检查训练步数和新阈值。
- 一次过早的平台判断。 s80 回落时,助手判断已达长度上限造成的天花板;s100 提升到 51.5%,推翻了这个判断。
- 完成 140 步。 最终验证为 54.4%;公开收尾附近的 worker 异常,保留完整统计口径。
下载与检查
代码与原创文档按 Apache-2.0 发布。压缩包包含实际 9,000 条训练数据、1,000 条验证数据、启动脚本、判分函数、依赖快照、脱敏日志和 CPU 校验工具。
unzip naive-claude-char-count-v1.0.0.zip
cd naive-claude-char-count
python3 -m venv .venv
.venv/bin/pip install -r requirements-analysis.txt
.venv/bin/python -m unittest discover -s tests -v
以上检查无需 GPU;完整训练环境与命令见复现指南。
如何理解这个结果
这是单次实验,使用历史容错判分,允许回退到尾部数字;不是严格格式准确率,也不是独立盲测。训练与验证数据之间有 62 个相同的唯一问题,生成器没有强制跨集合去重。
日志在完成 140 步附近包含 DataLoader worker 被终止的信息;最终指标已记录。历史模型权重和容器此前已被清理,本次开源没有重跑完整 GPU 训练,不包含模型权重。