Naive × Claude Code:一次 char count 直接 GRPO 实验
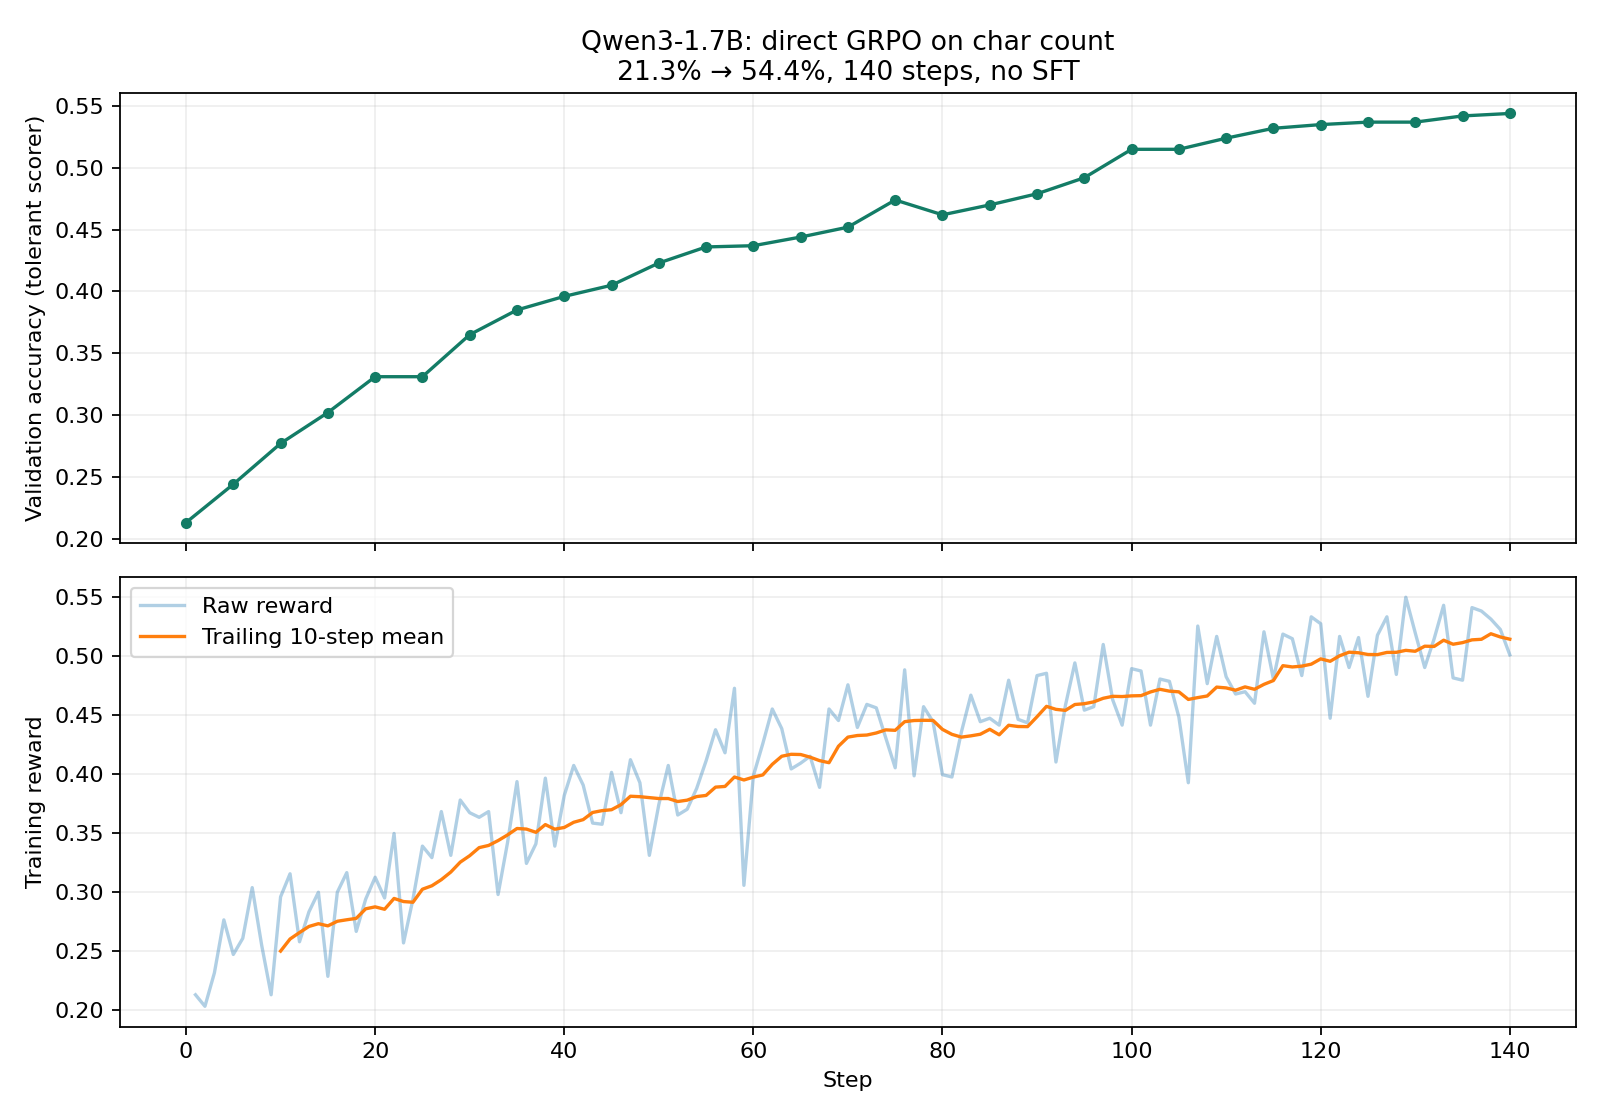
记录 Naive 在 Claude Code 中辅助完成的训练:Qwen3-1.7B,不做 SFT,单卡 GRPO,验证准确率 21.3% → 54.4%(+33.1 个百分点)。
Naive 是研发助手,Claude Code 是运行工具,Qwen3-1.7B 是被训练的模型。会话记录中的助手型号为 naive-n0.5-flash,不据此推断底层供应商。本仓库公开训练代码、实际数据、指标与过程;不包含模型权重。
实验概况
| 项目 | 本次设置 |
|---|---|
| 日期 | 2026-11-01(UTC) |
| 模型 | Qwen/Qwen3-1.7B,关闭 thinking,全参数训练 |
| 硬件 | 单张 RTX 4090 48GB,约 64GB 系统内存 |
| 框架 | verl + vLLM,FSDP2,参数与 optimizer CPU offload |
| 数据 | 随机合成字符串,字符以 - 分隔,长度 5–20;train 9000 / val 1000 |
| 算法 | GRPO;无 SFT;KL loss 与 reward KL 均关闭 |
| 更新 | lr=1e-6;128 prompts × 8 rollouts;mini-batch=16;micro-batch=8 |
| 长度 | prompt / response 上限均为 128 tokens |
| 训练 | 2 epochs,140 步,每 5 步验证,含训练前基线 |
| 用时 | 训练进度条 1:49:50;含启动约 1h51m |
| 判分 | 历史容错判分,详见 src/reward_tolerant.py |
这是单次实验和固定验证集的结果,不是多 seed 平均,也不是独立盲测。数据生成器未强制去重,核对发现训练/验证间有 62 个相同的唯一问题,详见来源说明。容错判分可能把末尾无关数字计为正确,因此不等同于严格格式准确率,不能直接与官方 recipe 的结果横比。
先看过程
- 实验过程与判断修正:135M 试跑、人工换模、监控、平台误判与最终结果。
- 公开对话摘录:保留当时的预测和误判,以实验报告和日志为准。
- 来源、复现边界及公开范围。
- 原始逐步指标和脱敏训练日志。
只核对数据和画图(无需 GPU)
需要 Python 3.12。以下命令都从仓库根目录执行:
python3 -m venv .venv
.venv/bin/pip install -r requirements-analysis.txt
.venv/bin/python -m unittest discover -s tests -v
.venv/bin/python scripts/extract_metrics.py archive/training.sanitized.log /tmp/char-count-metrics.csv
.venv/bin/python scripts/plot_metrics.py
测试检查全部 10,000 道题的真实字符计数、从日志重建全部 141 行指标与来源行号,以及判分的格式优先级和已知宽松行为。source_line 按 Python splitlines() 计算,包括日志中的 CR 进度更新。
复跑训练
在 Linux + NVIDIA GPU 环境中执行,需要 Git、Python 3.12、uv,以及兼容 CUDA 13 的驱动/系统依赖。本次配置以 48GB 显存、64GB RAM 的机器为参考,并未验证普通 24GB 4090。
训练依赖锁定在 verl commit 1876b06:torch 2.11.0、vLLM 0.24.0,完整依赖见 archive/uv.lock。准备脚本会核对 commit、lock 与 pyproject,而后同步 vllm/fsdp 环境并补装历史使用的 MLflow 3.17.2。安装体积较大。
bash scripts/setup.sh
mkdir -p models
.cache_verl/.venv/bin/hf download Qwen/Qwen3-1.7B --local-dir models/Qwen3-1.7B
bash scripts/train.sh
setup.sh 默认创建 .cache_verl。如系统缺少 CUDA 编译环境或 FlashAttention 系统依赖,可在这个固定版本的 verl 所提供的 docker/Dockerfile.uv.cu130 环境中执行;原实验的本地镜像已删除,仓库不提供可拉取的历史镜像。仓库路径请避免空格,以兼容上游 Hydra/uv 启动方式。
默认使用已保存的原实验 parquet 数据。模型下载未锁定历史 Hugging Face revision,因为记录中无法确认它;重新下载同名模型不保证字节相同。若已有本地模型和 verl 环境:
MODEL_PATH=/absolute/path/to/Qwen3-1.7B VERL_DIR=/absolute/path/to/verl bash scripts/train.sh
默认只输出 console,不要求访问原实验内网 MLflow。需要记录到自己的 MLflow 时:
MLFLOW_TRACKING_URI=http://localhost:5000 LOGGER='["console","mlflow"]' bash scripts/train.sh
历史设置为 save_freq=-1。如果希望保存新实验的权重,显式覆盖参数;这属于新实验配置:
bash scripts/train.sh trainer.save_freq=20
其他 Hydra 参数可追加在命令末尾。scripts/train.sh 保留原训练超参数,仅调整路径和日志服务配置;archive/launch_char_count.original.sanitized.sh 用于审计原配置,不作为可移植入口。
生成一份新数据
.venv/bin/python scripts/create_dataset.py --seed 42 --data_path /tmp/new-char-count
TRAIN_FILE=/tmp/new-char-count/rl/train.parquet TEST_FILE=/tmp/new-char-count/rl/test.parquet bash scripts/train.sh
历史生成器没有固定 Python random seed,因此此命令生成的是新数据,无法重建历史数据的相同字节。公开版增加 seed 并去掉生成器对 verl 的依赖,原生成器另存于 archive/。SFT 格式数据是生成器兼容输出,本次没有用来训练。
验证范围与许可证
发布整理已执行 CPU 侧的数据、指标、判分测试和 shell 参数检查;没有重新执行整轮 GPU 训练,也没有重建历史容器。训练完成附近的日志含 DataLoader worker 被 kill 的异常,详见过程说明。
代码与本仓库原创文档按 Apache-2.0 开源;第三方代码保留其版权与许可证,见 NOTICE。不分发 Qwen 权重,其使用条件由模型原仓库决定。